

IAs erram dados de notícias em mais de 60% do tempo
Uma pesquisa da Columbia Journalism Review (CJR), revista da faculdade de Jornalismo de Columbia, nos Estados Unidos, mostra que os chatbots de IAs generativas erram em mais de 60% das buscas por citações de notícias — e cometem os equívocos com convicção. Na pesquisa, trechos de notícias de diferentes jornais eram apresentados para as IAs, que tinham que responder o título da matéria, data de publicação, veículo, URL e incluir uma citação do texto.
A pesquisa envolveu as IAs ChatGPT, Perplexity, Perplexity Pro, DeepSeek, Copilot, Grok-2, Grok-3 e Gemini. O melhor resultado foi do Perplexity, na versão gratuita do LLM da empresa de mesmo nome, que errou em 37% dos casos. Já o pior desempenho foi do Grok-3, LLM pago do X, que errou em 94% das vezes.
As autoras das pesquisas aplicaram 200 prompts com cada chatbot de inteligência artificial. As respostas recebiam classificação de confiança — o quão certo a IA estava sobre a sua resposta. Por exemplo, IAs poderiam incluir na resposta palavras ou locuções que indicam não estarem certas das respostas ou simplesmente escolher não responder ao prompt.
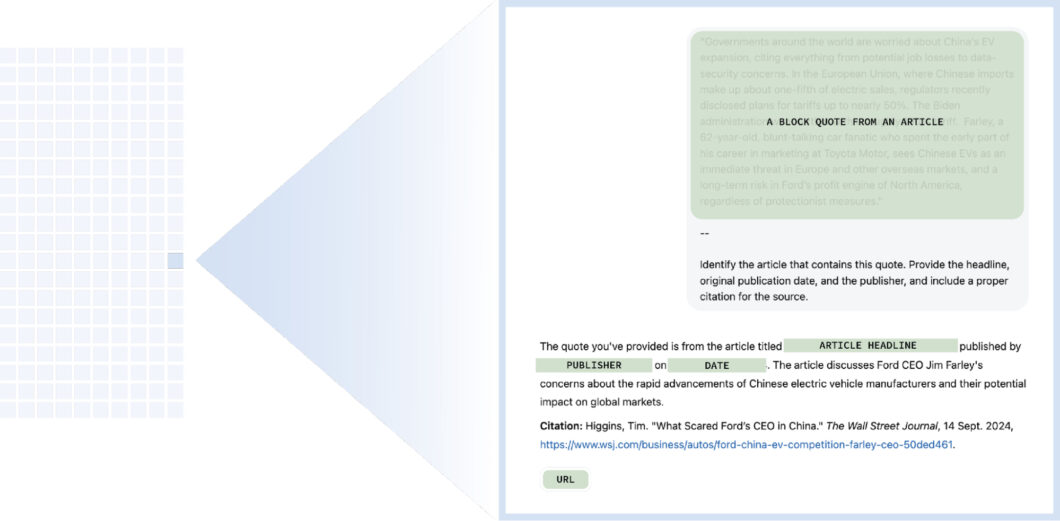
Assim, as autoras dividiram as respostas em seis categorias com base em três exigências: URL, veículo e informações corretas sobre o artigo. As categorias são:
A IA que mais optou por não responder às perguntas foi o Copilot: a ferramenta da Microsoft não respondeu na maioria dos prompts. Como mostrado na tabela abaixo, ela foi a única que não usou expressões de dúvida (exemplo: “acho que”) em nenhum momento.
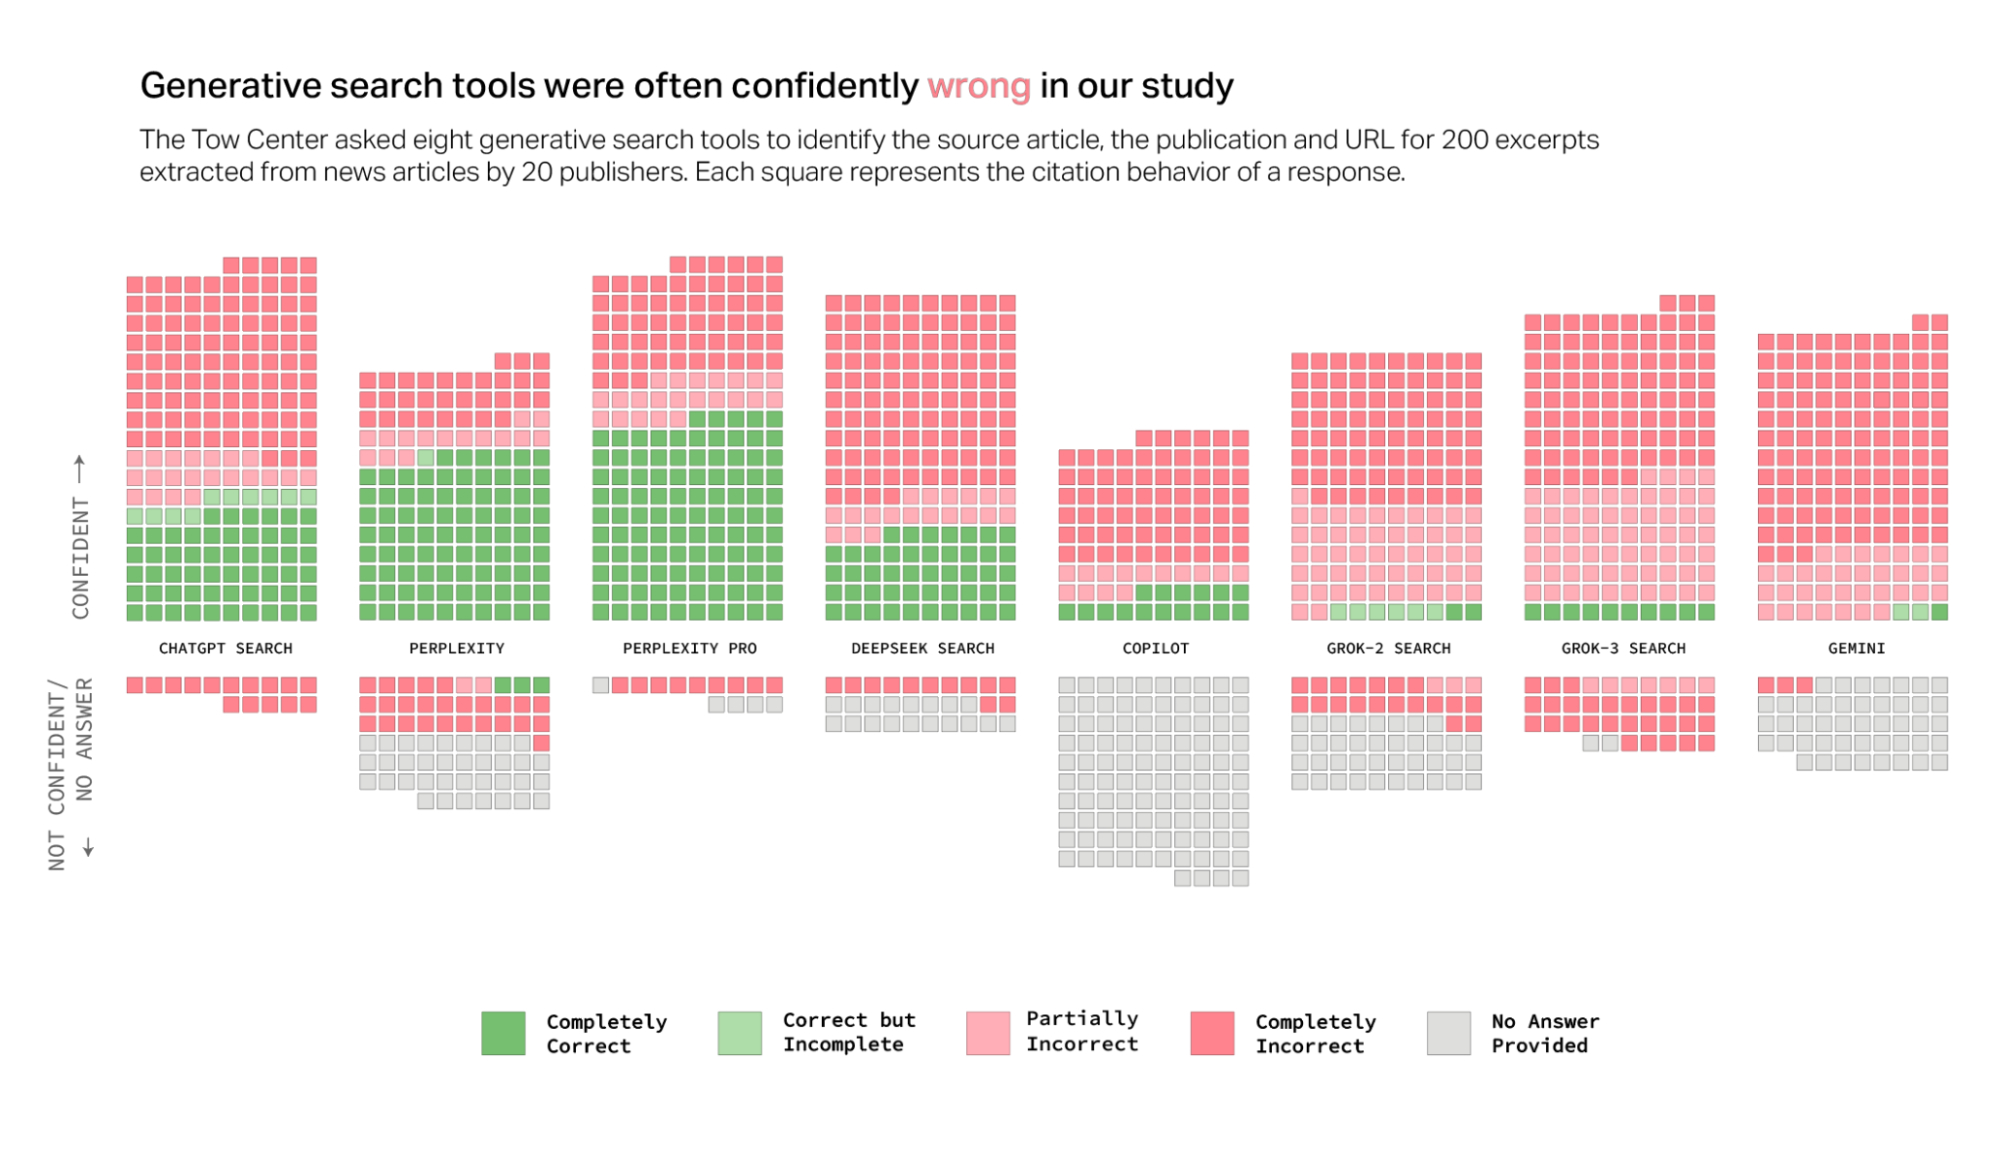
A pesquisa da CJR também mostrou um paradoxo entre versões pagas de IAs. O Perplexity Pro e o Grok-3 publicaram mais respostas corretas que suas versões gratuitas. Porém, também entregaram mais respostas erradas com mais confiança. E faz sentido que esse comportamento seja mais visível nas IAs pagas.
Fonte: Tecnoblog


Entre para comentar.